CustomGPT.ai เป็นตัวเลือกสำหรับองค์กรที่อยากให้พนักงานหรือลูกค้าถามข้อมูลจากเว็บไซต์ คู่มือ และเอกสารที่ดูแลอยู่แล้ว โดยไม่สร้างระบบค้นคืนข้อมูลเอง จุดที่ต้องตรวจคือคำตอบอ้างเอกสารถูกส่วนหรือไม่ และเมื่อแก้เอกสารแล้วคำตอบเปลี่ยนตามหรือเปล่า
ตรวจเงื่อนไขการเก็บไฟล์และบทสนทนาก่อนนำข้อมูลจริงเข้าไปด้วย ข้อมูล ณ 1 สิงหาคม 2026 มีแหล่งรีวิวภายนอกที่นับเป็นอิสระได้เพียงสามกลุ่ม และ PickByTask ยังไม่ได้ทดสอบ จึงยังสรุปความแม่นยำหรือความเหมาะสมกับข้อมูลขององค์กรคุณไม่ได้
สารบัญ — เลือกหัวข้อที่อยากอ่าน
CustomGPT.ai ทำงานกับความรู้ขององค์กรอย่างไร
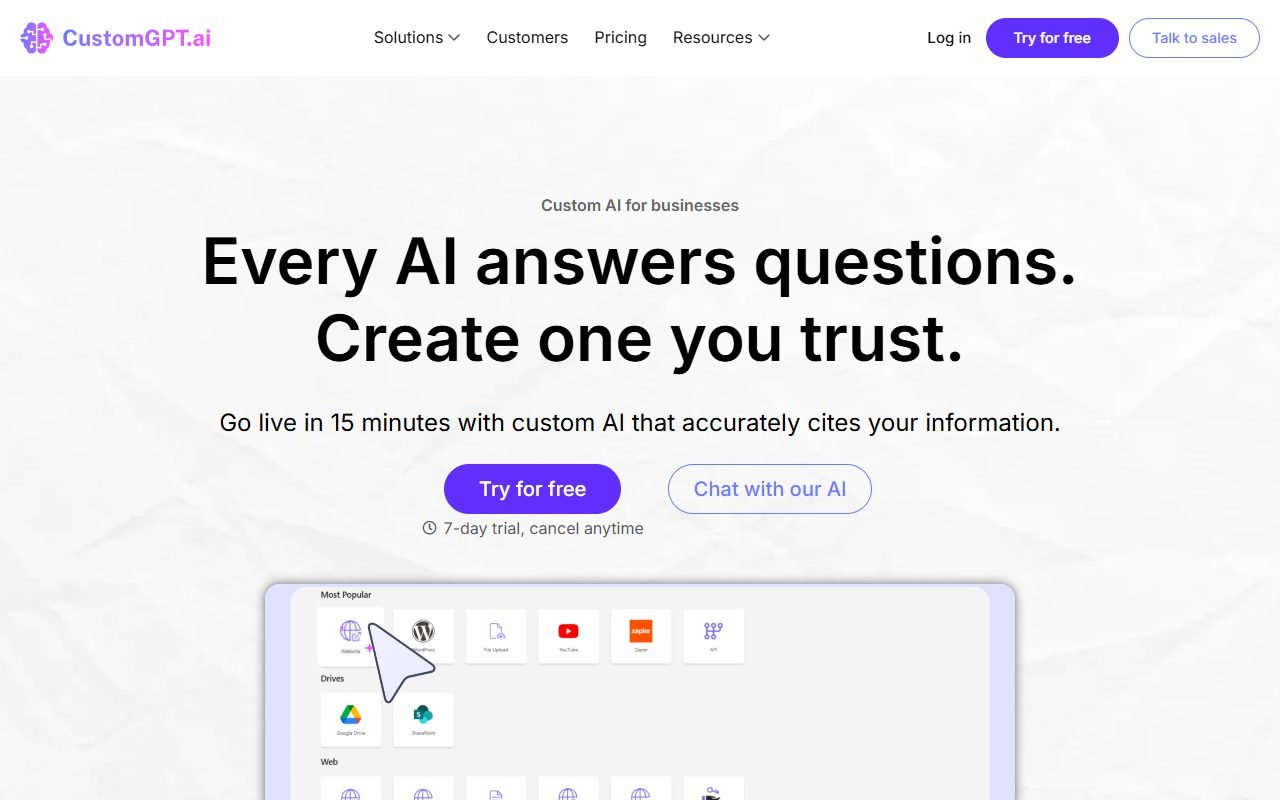
ภาพรวมในเอกสาร ระบุการนำเข้าเว็บไซต์และไฟล์หลายรูปแบบ การสร้าง agent แบบ no-code การอ้างแหล่งที่มา และการเชื่อม API ข้อความนี้เป็น provider claim คำว่า “อ้างอิงแหล่งที่มา” ต้องทดสอบทั้ง citation precision, citation coverage และกรณีเอกสารสองฉบับขัดกัน
หน้า CustomGPT.ai วางผลิตภัณฑ์สำหรับ chatbot จาก business content และกล่าวถึง security/compliance ในระดับผู้ให้บริการ ก่อนใช้เอกสารภายใน ทีมต้องขอ DPA/security evidence ที่ตรงกับแผน ตรวจ region, subprocessors, retention, training use, deletion และผู้ที่เข้าถึง conversation log
เหมาะกับ use case แบบไหน
- ศูนย์ช่วยเหลือลูกค้าที่มี help center และต้องการให้ bot ตอบพร้อมลิงก์ต้นฉบับ
- ทีมภายในที่ค้น SOP, policy หรือ product manual หลายชุด
- เว็บไซต์สมาชิกที่ต้องฝัง widget และควบคุมชุดความรู้ต่อ agent
- นักพัฒนาที่ต้องการ RAG API แต่ไม่อยากดูแล ingestion และ retrieval infrastructure เอง
ไม่เหมาะเมื่อความรู้เปลี่ยนรายนาทีแต่ทีมไม่มี source-refresh process หรือคำตอบผิดหนึ่งครั้งมีผลทางกฎหมาย/สุขภาพ/การเงินสูง หากเอกสารมี permission หลายระดับ ต้องยืนยันว่า retrieval enforcement ตรงกับ ACL จริง ไม่ใช่เพียงซ่อนหน้า UI
 ไปที่เว็บไซต์ CustomGPT.ai ↗
การทดสอบที่สำคัญกว่าหน้า demo
สร้าง corpus จำลอง 30 เอกสาร มีข้อมูลล่าสุด ข้อมูลเก่า ข้อความที่ขัดกัน ตาราง และ PDF scan เตรียมคำถาม 40 ข้อพร้อมคำตอบที่ผู้เชี่ยวชาญอนุมัติ วัด:
- answer correctness และ refusal เมื่อไม่มีข้อมูล
- citation ชี้หน้าหรือย่อหน้าที่สนับสนุนคำตอบจริง
- ความสดหลังแก้ source และเวลาที่ใช้ re-index
- การแยก agent/role และการรั่วข้อมูลข้ามชุด
- คำถามไทย การตัดคำ ชื่อเฉพาะ และเอกสารสองภาษา
- API timeout, rate limit, logging และ deletion
ห้ามเรียกผลลัพธ์ว่า hallucination-free จากคำอธิบายผู้ให้บริการ ต้องเก็บคำถามที่ตอบผิดและคะแนนตาม fixture เดียวกับ Chatbase/Botpress หรือ RAG ที่ทีมสร้างเอง
ราคาและต้นทุน
Pricing แสดงแผนตามระดับการใช้งานและ trial ตามเงื่อนไขปัจจุบัน ราคากับเครดิตเปลี่ยนแปลงได้จึงไม่ตรึงตัวเลขไว้ที่นี่ ต้นทุนจริงควรรวมจำนวน agent, query/credit, storage, crawl frequency, team access, API และเวลาที่คนใช้แก้ source
แผนทดลองมีประโยชน์เมื่อใช้เอกสารจำลอง ห้ามนำ policy ลูกค้า สัญญา หรือข้อมูลส่วนบุคคลขึ้นระบบเพื่อ “ลองก่อน” หาก privacy review ยังไม่ผ่าน
Ownership และความปลอดภัย
Security ระบุ controls และ compliance จากฝั่งผู้ให้บริการ ส่วน Terms กำกับสิทธิ์และหน้าที่การใช้บริการ ทีมต้องแยกสามเรื่อง: ใครเป็นเจ้าของเอกสาร, ผู้ให้บริการประมวลผลอย่างไร, และใครในองค์กรมีสิทธิ์ถามหรือดู log
หากใช้เอกสารมีลิขสิทธิ์จาก vendor หรือลูกค้า ต้องมีสิทธิ์นำมา ingest ด้วย การซื้อหนังสือหรือรายงานไม่ได้แปลว่าอนุญาตให้นำทั้งชุดไปสร้าง chatbot สาธารณะ
ไปที่เว็บไซต์ CustomGPT.ai ↗หลักฐานรีวิวภายนอกและช่องว่างที่ยังเหลือ
G2 มีเสียงผู้ใช้เรื่องการนำเข้าข้อมูล ความง่าย และ citation พร้อมประเด็นที่ควรตรวจเรื่องราคาและการตั้งค่า Capterra เป็น aggregate อีกกลุ่มหนึ่ง แต่หน้าในเครือ Gartner หากมีจะไม่ถูกนับซ้ำเป็นหลักฐานอิสระ
Product Hunt สะท้อน feedback จาก early adopters/maker community ซึ่งมี selection bias ทางบวกสูงกว่า long-term customer review Trustpilot ที่พบยังไม่เพียงพอให้ถือเป็นแหล่งเนื้อหารีวิวคุณภาพอีกกลุ่ม ณ วันที่ตรวจ
เมื่อแยกคำรับรองของผู้ให้บริการ directory ที่ไม่มีเนื้อหารีวิว และบทความที่เผยแพร่ซ้ำออก หลักฐานเหลือรีวิวอิสระเพียงสามกลุ่ม จึงยังสรุปประสบการณ์ของผู้ใช้ในวงกว้างอย่างมั่นใจไม่ได้ จำนวนลิงก์ที่มากขึ้นไม่ได้แปลว่าเป็นหลักฐานอิสระมากขึ้นเสมอ
Verdict
CustomGPT.ai มี proposition ชัดสำหรับทีมที่ต้องการ managed RAG พร้อม citation, widget และ API แต่คำตัดสินต้องรอ corpus test และหลักฐานภายนอกเพิ่ม ถ้าต้องควบคุม retrieval pipeline หรือ self-hosting เป็น requirement ให้เทียบ Botpress หรือระบบ RAG ที่ทีมเป็นเจ้าของ หากต้องการ bot แบบง่ายจาก FAQ ให้เทียบต้นทุนกับ Chatbase
Ingestion freshness และวงจรแก้ข้อมูล
กำหนด source owner ต่อเอกสารและ SLA ว่าข้อมูลใหม่ต้องปรากฏในคำตอบภายในกี่ชั่วโมง ทดสอบสามเหตุการณ์: เพิ่มหน้าใหม่ แก้ราคาบนหน้าเดิม และถอน policy เก่า จากนั้นถามคำถามเดิมก่อนและหลัง refresh พร้อมตรวจว่า citation ชี้ฉบับล่าสุดจริง
หาก crawler ดึงหน้า navigation, cookie banner หรือ duplicate URL เข้ามา corpus จะมี noise ควรบันทึก include/exclude rule, canonical, language และวันที่ crawl แยกจากวันที่ผู้ใช้แก้เนื้อหา Failure ที่ต้องตรวจไม่ใช่แค่ fetch error แต่รวม “fetch สำเร็จแต่ index ยังตอบข้อมูลเก่า”
ACL และกรณีข้อมูลรั่ว
สร้างเอกสารสี่ชั้น: public, customer A, customer B และ HR-confidential แล้วใช้บัญชี/agent ทุก role ถามทั้งตรง อ้อม และด้วยคำขอให้สรุป source ทั้งหมด เกณฑ์ผ่านคือปฏิเสธข้อมูลที่ไม่มีสิทธิ์และไม่เผยชื่อไฟล์ citation หรือ snippet ที่บอกสาระลับ
ตรวจว่าการแยก agent เป็นขอบเขตความปลอดภัยจริงหรือเป็นเพียงการจัดกลุ่มในหน้าผู้ดูแล ทดสอบ API key ที่ถูกถอน วิดเจ็ตบนโดเมนที่ไม่อนุญาต และการส่งออกบทสนทนาของผู้ใช้อื่น หากขอบเขตใดยังไม่ยืนยัน ให้จำกัดผลิตภัณฑ์ไว้กับข้อมูลสาธารณะจนกว่าจะตรวจความเสี่ยงของผู้ให้บริการครบ
ไปที่เว็บไซต์ CustomGPT.ai ↗Support, export และ exit plan
ส่งคำถาม support ที่มี fixture ชัด: citation ผิดหลังอัปเดตเอกสาร บันทึกช่องทาง เวลาตอบ ขั้นตอนวินิจฉัย และวิธี escalation ถามเพิ่มว่าส่งออก source inventory, agent config, conversation log และ analytics ในรูปแบบใดได้บ้าง ไม่ควรถือว่า API access เท่ากับ export configuration ทั้งระบบ
Exit plan ต้องระบุว่าเมื่อลบบัญชีจะถอน widget/key อย่างไร เก็บสำเนา source ที่ทีมเป็นเจ้าของไว้ที่ใด และสร้าง bot สำรองจากอะไร หาก export ได้เฉพาะข้อมูลแต่ไม่รวม retrieval tuning หรือ prompt configuration ต้นทุนย้ายคือเวลาสร้างใหม่ ซึ่งต้องรวมใน TCO
ตารางตัดสินใจและข้อจำกัดก่อนใช้งานจริง
| สิ่งที่ต้องการ | สิ่งที่ต้องเห็นก่อนเลือก | สถานะหลักฐาน |
|---|---|---|
| การอ้างอิงที่ตรวจสอบได้ | ความแม่นยำ/ความครอบคลุมด้วยชุดคำตอบมาตรฐาน และการจัดการข้อมูลขัดแย้ง | รอทดลองใช้งานจริง |
| ภาษาไทย | การค้นคืน คำตอบ และการอ้างอิงจากคลังข้อมูลสองภาษา | รอทดลองใช้งานจริง |
| ข้อมูลภายใน | DPA, retention, ACL isolation และ deletion | รอ security review |
| predictable cost | query/credit/API/storage จาก workload จริง | รอ trial |
| หลักฐานภายนอก | รีวิวอิสระอย่างน้อย 6 แหล่ง | หลักฐานยังไม่ครบ: มี 3 กลุ่ม |
แม้การทดสอบผลิตภัณฑ์จะผ่านทุกข้อ ก็ยังไม่ควรใช้ข้อสรุปเป็นคำแนะนำที่หนักแน่นจนกว่าช่องว่างของหลักฐานจะถูกแก้ด้วยแหล่งที่มีเนื้อหาและความน่าเชื่อถือจริง คำรับรองของผู้ให้บริการหรือ directory ซ้ำไม่นับเป็นฉันทามติอิสระ
FAQ
CustomGPT.ai ฝึกโมเดลใหม่จากเอกสารหรือไม่
ผลิตภัณฑ์อธิบายแนวทาง agent จาก content/RAG แต่รายละเอียดการใช้ข้อมูลต้องอ่าน privacy, terms และ DPA ของแผนในวันใช้งาน ห้ามใช้คำว่า “ไม่ฝึกแน่นอน” โดยไม่มีเอกสารตรง
รองรับภาษาไทยหรือไม่
เอกสารระบุหลายภาษา แต่ยังไม่มี test fixture ภาษาไทยของ PickByTask ต้องทดสอบการตัดคำ citation และคำถามสองภาษา
ใช้แทนเจ้าหน้าที่ได้หรือไม่
ไม่ควรตั้งเป้าแทนทั้งหมด งานควรมี escalation เมื่อ confidence ต่ำ ไม่มี source หรือคำถามมีผลสูง และต้องตรวจ log เพื่อปรับ corpus